KI im Data Engineering: Der Agent schreibt die Pipeline. Teurer wird das Team trotzdem.
In den Budgetgesprächen für 2027 taucht gerade eine Annahme auf, die niemand ausspricht, aber fast jeder bereits einrechnet: Wenn der Agent die Pipelines schreibt, braucht das Data-Team weniger Menschen.
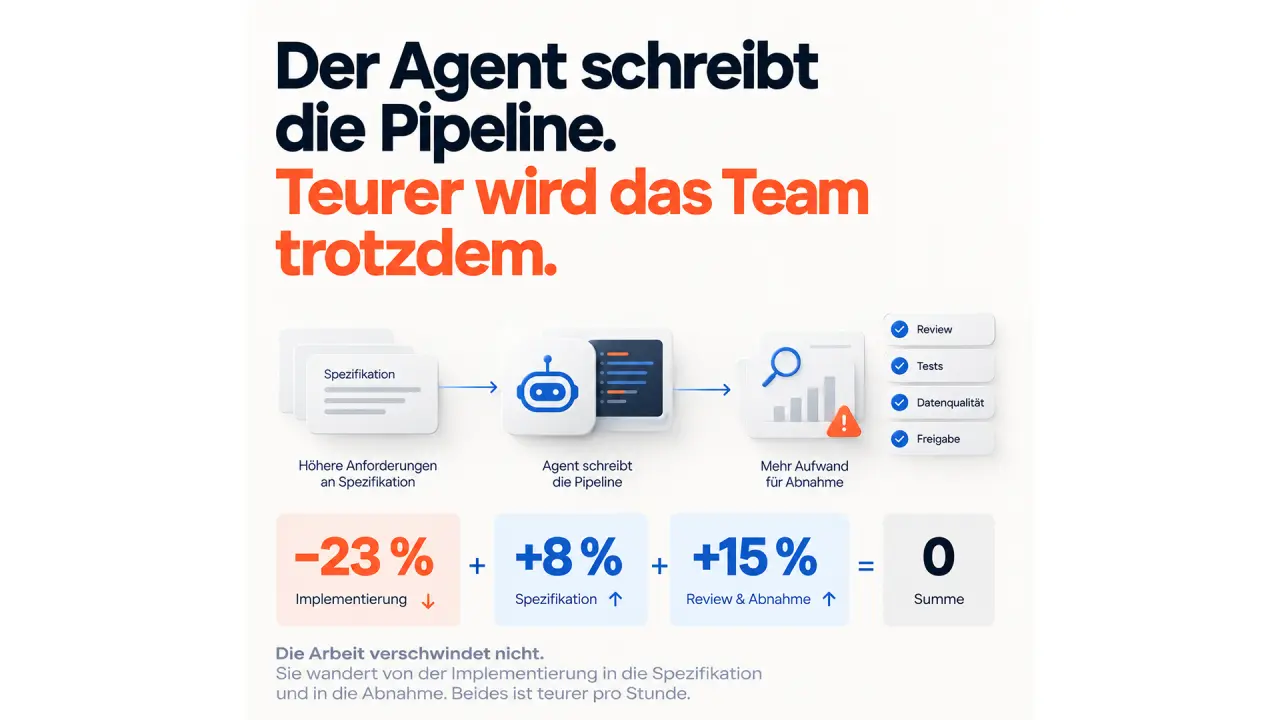
Ich halte diese Annahme für falsch. Nicht aus Prinzip, sondern aus Arithmetik. Die Arbeit verschwindet nicht. Sie wandert von der Implementierung in die Spezifikation und in die Abnahme. Und beides ist pro Stunde teurer als ein großer Teil der Arbeit, die wegfällt.
Die Zahl, die man kennen sollte, bevor man das Data-Team kürzt
METR hat im Juli 2025 etwas gemacht, das in dieser Debatte noch immer selten ist: eine randomisierte kontrollierte Studie. 16 erfahrene Open-Source-Entwickler bearbeiteten 246 reale Issues aus Repositories mit mehr als einer Million Codezeilen. Die Aufgaben dauerten im Schnitt rund zwei Stunden. Wichtig dabei: Es waren keine fremden Codebasen. Die Entwickler hatten über Jahre selbst an diesen Repositories mitgearbeitet.
Das Ergebnis: Mit KI-Werkzeugen waren die Entwickler 19 Prozent langsamer. Vor der Studie hatten sie erwartet, durch KI 24 Prozent schneller zu werden. Danach glaubten sie immer noch, rund 20 Prozent schneller gewesen zu sein.
Die interessante Zahl ist für mich nicht die 19. Es ist die Lücke von ungefähr 40 Prozentpunkten zwischen gefühlter und gemessener Leistung. Menschen, die täglich mit diesen Werkzeugen arbeiten, konnten ihre eigene Verlangsamung nicht erkennen.
Die Studie hat Schwächen. Sie ist klein, sie lief mit Modellen vom Anfang 2025, und sie betrachtet eine sehr spezifische Situation: erfahrene Entwickler, die an großen, etablierten Open-Source-Repositories arbeiten, die sie sehr gut kennen. Ich führe sie trotzdem an, weil sie eine der saubersten Messungen ist, die ich kenne, und weil das Muster mit dem übereinstimmt, was ich in Teams sehe.
Was sich tatsächlich verschiebt, wenn KI die Pipeline schreibt
In den Data-Teams, die ich begleite, verteilt sich die Arbeit grob so: 45 Prozent Implementierung, 20 Prozent Spezifikation und fachliche Abstimmung, 20 Prozent Review und Test, 15 Prozent Betrieb und Störungsbehebung. Das sind meine Erfahrungswerte, keine Benchmark.
Jetzt kommt der Agent, und er ist gut. Er halbiert den Implementierungsaufwand. Aus 45 Prozent werden 22. In einem Team mit sechs Leuten sieht das nach rund 1,4 freigewordenen Vollzeitstellen aus. Genau diese Zahl landet dann im Budgetentwurf.
Was im selben Entwurf fehlt, ist die Gegenbuchung. Der Agent braucht einen präzisen Zielzustand. Nicht: „Bau mir die Umsatzlogik nach.“ Sondern: Welche Quellen? Welche Granularität? Wie werden Stornos behandelt? Was passiert mit Nachbuchungen über einen Periodenschnitt hinweg? Wer das nicht vorher sauber beschreibt, bekommt Code, der läuft und trotzdem falsch ist. In meinen Projekten steigt der Anteil für Spezifikation von rund 20 auf etwa 28 Prozent.
Dann kommt die Abnahme. Der DORA-Report nennt das Verification Tax und sieht darin einen der Gründe für die anfängliche Delle in der KI-Produktivitätskurve.
Bei Anwendungscode ist dieser Prüfaufwand unangenehm. Bei Datenlogik ist er etwas anderes, und darüber reden wir aus meiner Sicht noch zu wenig.
Fehlerhafter Anwendungscode stürzt ab. Jemand sieht eine Fehlermeldung. Jemand wird angerufen. Jemand rollt zurück.
Eine fehlerhafte Transformation stürzt oft nicht ab. Sie liefert eine Zahl. Diese Zahl geht ins Reporting, in die Planung oder in die Provisionsabrechnung und sieht genauso aus wie alle anderen Zahlen.
Im illustrativen DORA-Modell steigt die Change-Failure-Rate nach Einführung von KI von 5 auf 6 Prozent. Daraus ergibt sich im Modellszenario ein negativer Downtime-Effekt von 344.000 US-Dollar. Das ist Software. Bei Daten fehlt in dieser Rechnung noch etwas Entscheidendes: die Zeit bis zur Entdeckung.
In einem Fall aus meiner Praxis lief eine falsche Aggregation elf Wochen, bevor sie jemandem auffiel. Die Korrektur der Logik dauerte einen Nachmittag. Die Rückabwicklung der Entscheidungen, die auf diesen Zahlen beruhten, beschäftigte uns ein Quartal.
Deshalb steigt der Review-Aufwand in Data-Teams stärker als in vielen klassischen Entwicklungsteams. Meine Erfahrungszahl: von rund 20 auf 35 Prozent.
Die Rechnung hinter KI im Data Engineering
Nehmen wir sechs Data Engineers mit internen Vollkosten von 110.000 Euro pro Kopf. Jahresbudget: 660.000 Euro.
Implementierung: minus 23 Prozentpunkte.
Spezifikation: plus 8 Prozentpunkte.
Review und Abnahme: plus 15 Prozentpunkte.
Summe: null.
Das Team wird im ersten Jahr nicht kleiner. Es macht andere Arbeit.
Und genau hier liegt der Punkt, der in keiner Budgetzeile steht. Die 23 Punkte, die wegfallen, sind überwiegend Arbeit, die ein Junior nach einer guten Einarbeitung übernehmen kann. Die 23 Punkte, die dazukommen, verlangen Domänenwissen und Entscheidungsbefugnis.
Der Personalaufwand kann ähnlich bleiben. Der Skill-Mix verschiebt sich nach oben. Wer heute drei Junioren und drei Senioren hat, braucht in zwei Jahren vielleicht eher einen Junior und vier Senioren.
Rechnen wir das durch. In den Projekten, die ich sehe, liegen die internen Vollkosten bei ungefähr 85.000 Euro für einen Junior und 135.000 Euro für einen Senior. Drei Junioren und drei Senioren ergeben 660.000 Euro. Ein Junior und vier Senioren ergeben bei fünf Köpfen 625.000 Euro. Bleibt das Team bei sechs Personen, liegt man eher bei 760.000 Euro.
Die Spanne zwischen diesen beiden Varianten, 135.000 Euro im Jahr, ist die eigentliche Entscheidung. Sie wird nur selten als solche geführt. Meist ergibt sie sich still daraus, wer das Unternehmen in den nächsten zwei Jahren verlässt und wer nachbesetzt wird.
Das Einsparpotenzial, das heute in vielen 2027er Budgets steht, ist noch nicht da. Es kann später kommen, aber nur unter einer Bedingung.
Die Bedingung heißt Prüfbarkeit
Der größere Punkt im DORA-Report lautet: Die größten Renditen entstehen nicht durch die Tools selbst, sondern durch die organisatorischen und technischen Grundlagen rundherum. Für Data-Teams wird das sehr konkret.
Abnahme wird billiger, wenn es Datenverträge gibt, die Regelverletzungen automatisch melden. Wenn Testfälle für die zwanzig wichtigsten Kennzahlen hinterlegt sind und bei jeder Änderung laufen. Wenn Lineage bis auf Spaltenebene reicht, sodass die Prüfung nicht jedes Mal bei null beginnt.
Der Einstieg ist kleiner, als viele Unternehmen annehmen. Man braucht keine vollständige Abdeckung. Man braucht die Kennzahlen, auf denen Entscheidungen beruhen, und für jede davon einen Test, der bei jeder Änderung läuft.
In den Unternehmen, die ich sehe, sind das irgendwo zwischen zwölf und dreißig Kennzahlen. Nicht zweihundert. Der Aufbau dafür dauert eher Wochen als ein Transformationsprogramm.
Teams, die diese Grundlage haben, bekommen einen großen Teil des zusätzlichen Review-Aufwands wieder zurück. Teams, die sie nicht haben, prüfen weiterhin von Hand. Dann beschleunigt der Agent nur ein Fundament, das diese Geschwindigkeit nicht tragen kann.
Deshalb bin ich bei der Reihenfolge so hartnäckig: Erst die Prüfbarkeit. Dann die Geschwindigkeit. Dreht man es um, entsteht genau die Situation, die METR gemessen hat: Alle fühlen sich schneller, niemand ist es, und keiner merkt es.
Die Gegenposition, die ich ernst nehme
Das stärkste Argument gegen alles, was ich bisher geschrieben habe, lautet: Du misst das erste Jahr und hältst es für den Endzustand.
Das ist fair. Die METR-Studie lief mit Modellen vom Anfang 2025. Die Werkzeuge in modernen Datenplattformen haben sich seitdem deutlich weiterentwickelt. Die J-Kurve, die DORA beschreibt, beginnt mit einer Delle und steigt danach wieder an. Wer wegen dieser Delle wartet, steht möglicherweise in zwei Jahren ohne ausgereifte Werkzeuge und ohne ein Team da, das gelernt hat, damit umzugehen.
Hinzu kommt ein Arbeitsmarktargument. Gartner erwartet, dass bis 2027 75 Prozent der Einstellungsprozesse Zertifikate oder Tests zur KI-Kompetenz im Arbeitsalltag enthalten werden. Wenn man dem eigenen Team diese Erfahrung vorenthält, macht man es für den Arbeitsmarkt schlechter aufgestellt und gleichzeitig schwerer zu halten.
Beides stimmt. Mein Einwand ist schmal, aber aus meiner Sicht entscheidend: Keines dieser Argumente rechtfertigt, die Einsparung heute schon in das Budget 2027 zu schreiben.
Mit den Werkzeugen anfangen: ja. Die Ersparnis vorab buchen: nein. Wer das tut, kürzt genau die Stellen, die später für Spezifikation und Abnahme gebraucht werden, und erzeugt damit die Instabilität, vor der das DORA-Modell warnt.
Was das für Data Leadership bedeutet
Die unangenehmste Folge ist nicht die Kostenrechnung. Es ist der Einstieg in den Beruf.
Die Arbeit, an der Data Engineers senior werden, ist zunehmend genau die Arbeit, die der Agent übernehmen kann: Pipelines bauen, Fehler suchen, verstehen, warum ein Join plötzlich Zeilen dupliziert, lernen, was passiert, wenn vermeintlich einfache Logik auf echte, unsaubere Daten trifft.
Wer diese Jahre nie durchlaufen hat, kann die Ausgabe eines Agenten später nur schwer beurteilen. Er kann sie im Zweifel nur glauben.
Wenn wir Einstiegspositionen streichen, weil der Agent die Junior-Arbeit übernehmen kann, fehlen uns in fünf Jahren möglicherweise genau die Menschen, die gelernt haben, die Arbeit des Agenten zu prüfen.
Das ist kein Arbeitsmarktproblem, das irgendwann irgendjemand anders löst. Es ist eine Entscheidung, die jedes Unternehmen für sich selbst trifft, meist ohne sie überhaupt als Entscheidung wahrzunehmen.
Meine Position ist einfach: Die Rolle verschwindet nicht. Der Einstieg verschwindet, wenn wir ihn nicht bewusst erhalten. Und das ist die teurere der beiden Entwicklungen.
Was mich interessiert
Habt ihr in eurem Data-Team seit dem Einsatz von KI-Agenten tatsächlich Kapazität gewonnen? Und wenn ja: gemessen oder nur gefühlt?
Ich meine die zweite Hälfte der Frage ernst.
Wenn Sie gerade prüfen, wie KI-Agenten die Struktur Ihres Data-Teams verändern könnten, buchen Sie ein 30-minütiges Exploration Call mit uns. Gemeinsam schauen wir darauf, wo Implementierungsaufwand tatsächlich sinkt, wo Spezifikation und Abnahme gleichzeitig steigen und welche Grundlagen vorhanden sein müssen, bevor aus diesen Effizienzgewinnen wirklich zusätzliche Kapazität wird.
Quellen
METR: Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity
DORA: ROI of AI-Assisted Software Development
Gartner: Top Predictions for Data and Analytics in 2026